8 · 근사 추정
확률 모델에서 가장 중요한 일 중 하나는 사후 분포나 그 기댓값을 계산하는 것이지만, 실제로는 이 계산이 불가능할 수 있다. 결정론적 근사 방법을 쓰면 유한한 시간 안에 근사해를 찾을 수 있다.
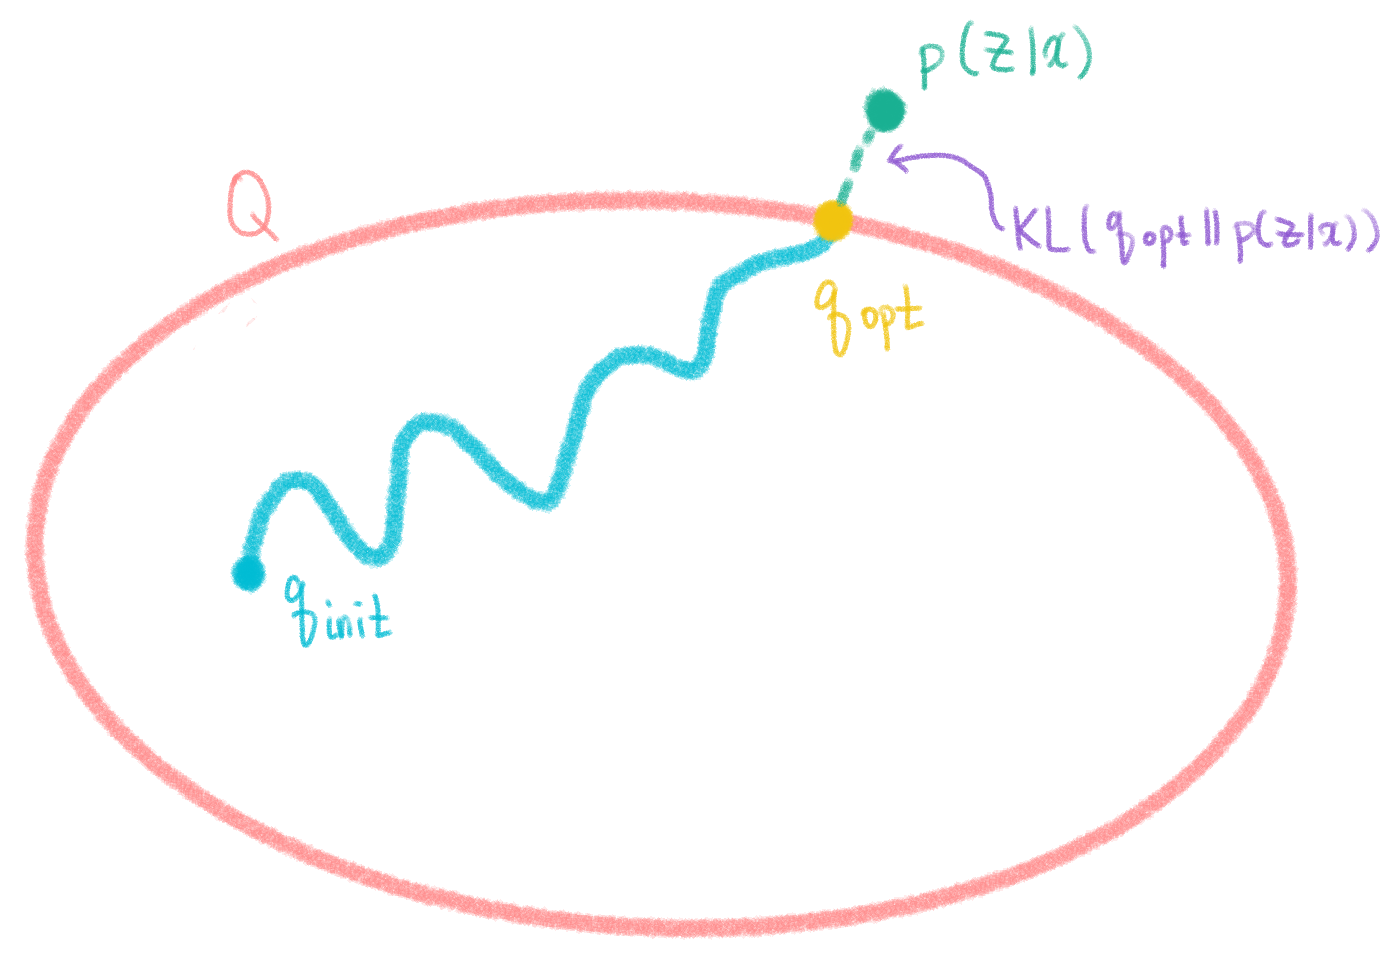
8.1 변분적 추론
- 변분적 방법은 변분법calculus of variations에 기반한다. 함수가 값을 받아 값을 내는 사상이라면, 범함수functional는 함수를 받아 값을 내는 사상이다(예: 엔트로피
). 잠재 변수·매개변수 전체를 , 관측 변수를 로 두면 로그 주변 확률은 다음처럼 분해된다.
- 하한
를 최대화하는 것은 쿨백–라이블러 발산Kullback–Leibler divergence을 최소화하는 것과 같다. 이면 이지만 실제 사후 분포는 다루기 어려우므로, 를 더 제한된 종류로 한정해 그 안에서 최적해를 찾는다.
8.1.1 인수분해된 분포
를 서로소 집합 로 나누고 가 이들에 대해 인수분해된다고 가정한다(평균장 근사mean-field approximation).
- 각 인자
에 대해 를 자유 형태로 변분 최적화하면, 최적 인자는 나머지 인자들에 대한 결합 로그 분포의 기댓값으로 주어진다.
각 인자가 다른 인자의 기댓값에 의존하므로, 인자들을 번갈아 갱신해 수렴시킨다.
8.1.2 인수분해 근사의 성질
- 상관된 2변수 가우시안
를 로 근사하면, (10.9)에서 각 인자가 가우시안이 되고
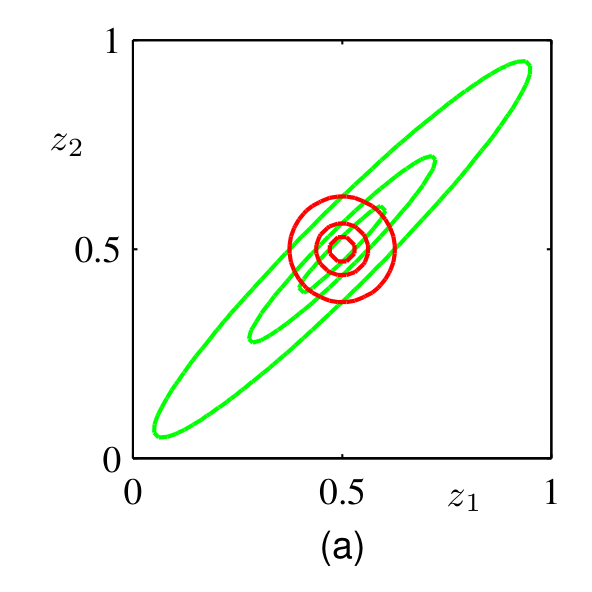
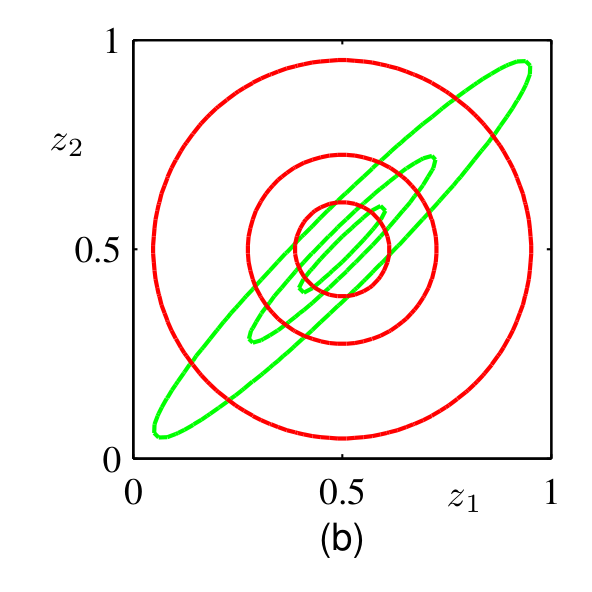
그림 8.1 · 상관된 가우시안
를 최소화하면 분포의 한 최빈값으로 붙는(mode-seeking) 경향이, 를 최소화하면 모든 최빈값을 평균 내는(mean-covering) 경향이 있다. 두 발산은 모두 알파족alpha family 발산 의 특수한 경우다( 는 , 는 , 은 대칭적 헬링거 거리Hellinger distance).
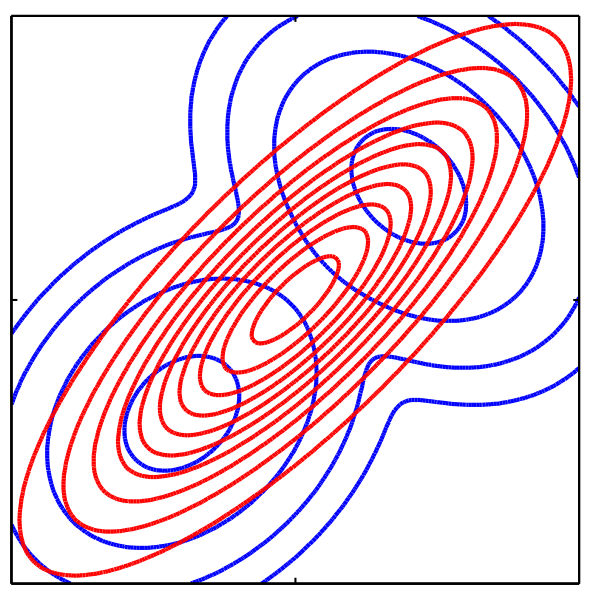
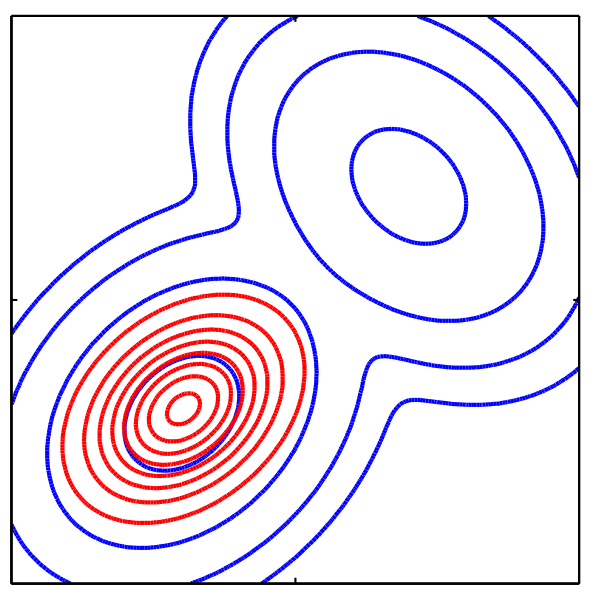
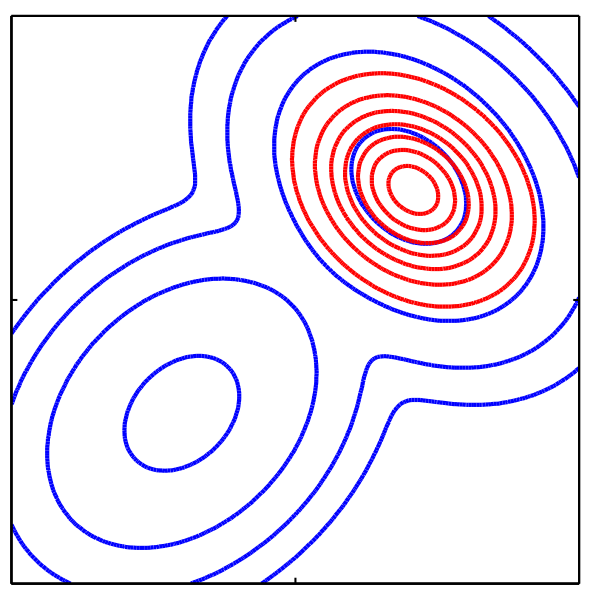
그림 8.2 · 양봉 분포
실습 · 인수분해 변분 근사의 분산 과소평가
상관된 2변수 가우시안을
import numpy as np
mu = np.array([0.0, 0.0])
Lam = np.array([[2.0, 1.6], [1.6, 2.0]])       # 정밀도 (상관이 큼)
Sigma = np.linalg.inv(Lam)
m = np.array([2.0, -1.0])                        # 초기값
for it in range(30):
    m1 = mu[0] - Lam[0,0]**-1 * Lam[0,1]*(m[1]-mu[1])
    m2 = mu[1] - Lam[1,1]**-1 * Lam[1,0]*(m1-mu[0])
    new = np.array([m1, m2])
    if np.linalg.norm(new-m) < 1e-12: m = new; break
    m = new
print("수렴 평균 q :", np.round(m, 4).tolist(), " (참 평균 [0, 0])")
print("q 분산(축별):", [round(float(1/Lam[0,0]),4), round(float(1/Lam[1,1]),4)])
print("참 주변 분산:", [round(float(Sigma[0,0]),4), round(float(Sigma[1,1]),4)])
print("→ 변분 근사가 주변 분산을 과소평가")실습 · 두 방향의 KL 발산 (
양봉 목표 분포를 단일 가우시안으로 근사할 때,
import numpy as np
def p(x):
    return (0.5*np.exp(-(x+2)**2/(2*0.5**2)) + 0.5*np.exp(-(x-2)**2/(2*0.5**2)))/np.sqrt(2*np.pi*0.5**2)
def gauss(x, mu, s): return np.exp(-(x-mu)**2/(2*s**2))/np.sqrt(2*np.pi*s**2)
xs = np.linspace(-8, 8, 4001); dx = xs[1]-xs[0]; px = p(xs)
# KL(p||q): 모멘트 매칭 (해석적)
Ep = np.sum(xs*px)*dx; Ep2 = np.sum(xs**2*px)*dx
mu_pm, s_pm = Ep, np.sqrt(Ep2-Ep**2)
# KL(q||p): 그리드 최소화
best = None
for mu_ in np.linspace(-4, 4, 81):
    for s_ in np.linspace(0.2, 3, 57):
        q = gauss(xs, mu_, s_); mk = q > 1e-12
        kl = np.sum(q[mk]*(np.log(q[mk])-np.log(px[mk]+1e-300)))*dx
        if best is None or kl < best[0]: best = (kl, mu_, s_)
print(f"KL(p||q) 모멘트매칭: μ={mu_pm:+.3f}, σ={s_pm:.3f}  (두 봉우리를 넓게 덮음)")
print(f"KL(q||p) 최빈값탐색: μ={best[1]:+.3f}, σ={best[2]:.3f} (한 봉우리에 붙음)")8.2 변분적 가우시안 혼합 분포 예시
- 베이지안 가우시안 혼합에서 잠재 변수
, 관측 에, 켤레 사전 분포로 에 디리클레, 에 가우시안–위샤트를 둔다.
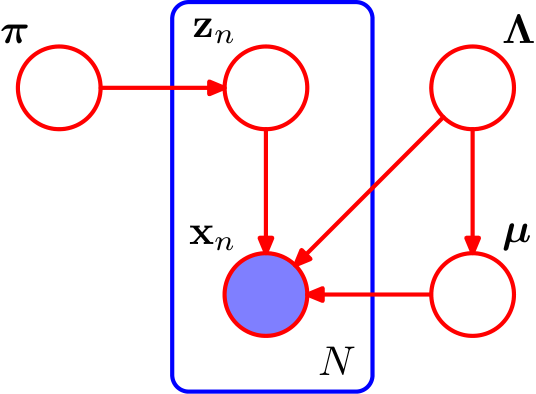
그림 8.3 · 베이지안 가우시안 혼합의 방향성 그래프. 판은
8.2.1 변분적 분포
로 인수분해하면 잠재 변수 인자는
로 정규화되며
8.3 변분적 선형 회귀
- 선형 회귀에 가능도
, 사전 분포 , 에 켤레 감마 사전 을 둔다.
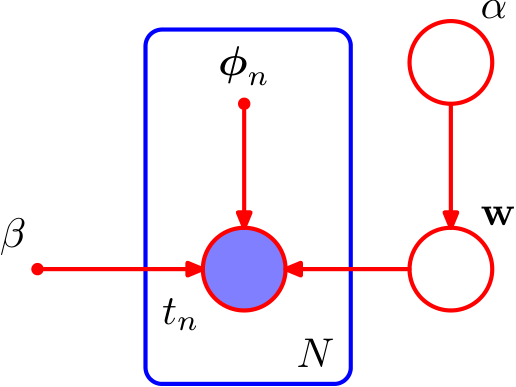
그림 8.4 · 베이지안 선형 회귀
8.3.1 변분적 분포
로 두면 는 감마 분포, 는 가우시안이 된다.
증거 최대화 EM 결과와 거의 같되,
8.3.2 예측 분포
- 예측 분포는
로 주변화해 얻는다.
8.4 지수족 분포
- 매개변수
는 수가 고정된 집중적intensive 변수, 잠재 변수 는 데이터가 늘수록 늘어나는 광역적extensive 변수다. 결합 분포가 지수족 이고 에 켤레 사전 분포를 두면, 의 두 인자를 닫힌 형태로 갱신할 수 있다( ).
8.5 지역적 변분 방법론
- 전역 변분법이 전체 사후 분포를 근사하는 반면, 지역적 변분법은 개별 변수·함수의 경계를 찾는다. 볼록 함수
의 접선은 하한이며, 기울기 의 접선을 로 쓰면 볼록 쌍대성convex duality으로
를 얻는다. 예컨대
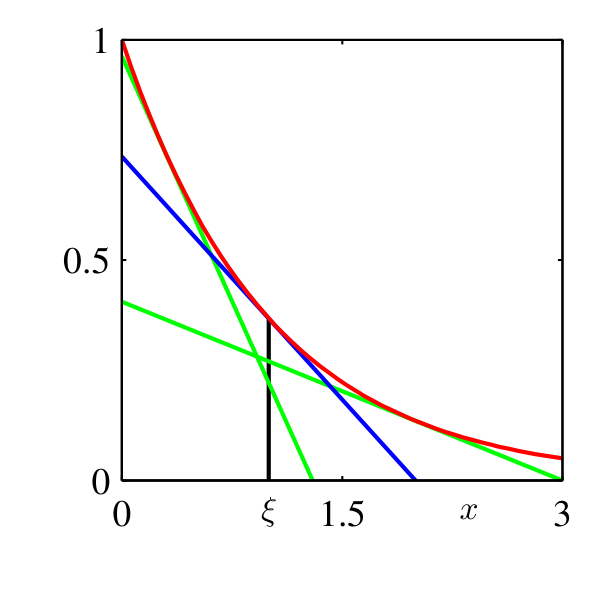
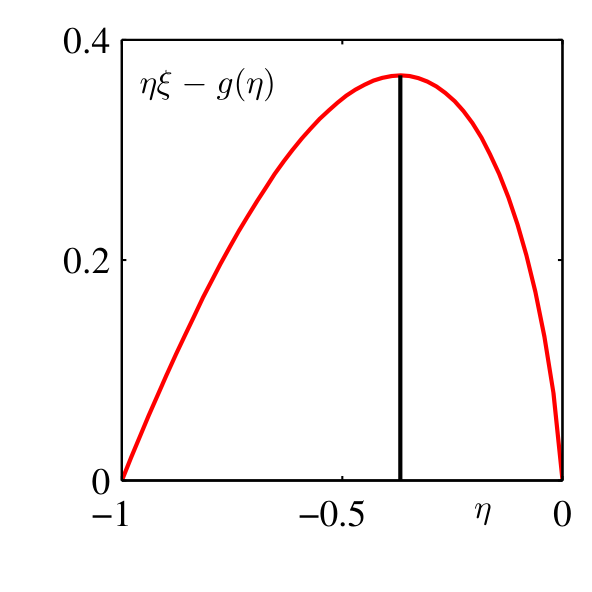
그림 8.5 · (왼쪽)
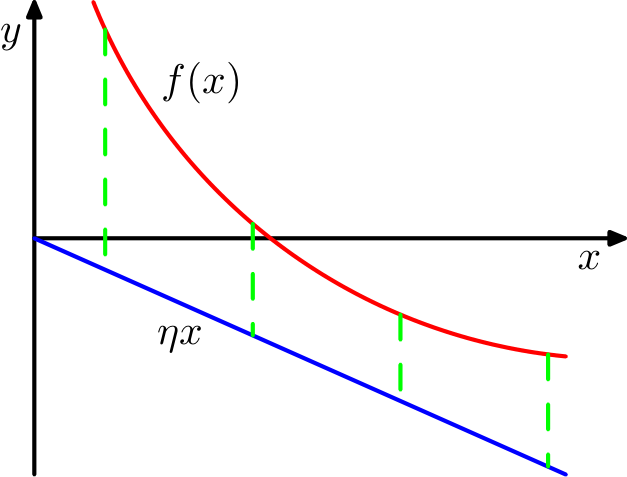
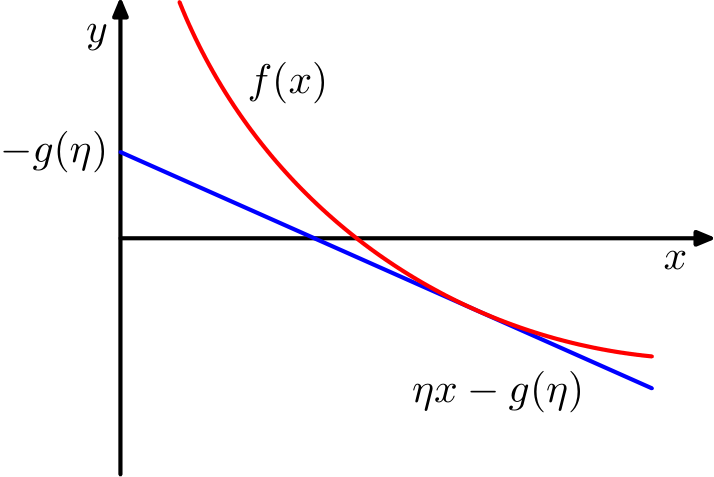
그림 8.6 · 볼록 함수
8.6 변분적 로지스틱 회귀
8.6.1 변분적 사후 분포
- 로지스틱 회귀의 주변 가능도
는 다룰 수 없다. ( )에 시그모이드의 변분 하한을 적용한다.
- 관측마다 변분 매개변수
을 두면 결합 분포의 하한이 에 대한 이차식이 되어, 사후 분포의 가우시안 근사를 얻는다.
실습 · 로지스틱 시그모이드의 변분 하한
import numpy as np
def sig(z): return 1/(1+np.exp(-z))
def lam(xi): return (sig(xi)-0.5)/(2*xi)
def bound(z, xi): return sig(xi)*np.exp((z-xi)/2 - lam(xi)*(z**2-xi**2))
xi = 2.0
print(f"변분 매개변수 ξ={xi} (z=±ξ에서 등호)")
print(f"  {'z':>4} {'σ(z)':>8} {'하한':>8} {'차이':>9}")
for z in [-3, -2, -1, 0, 1, 2, 3]:
print(f" {z:>4} {sig(z):>8.4f} {bound(z, xi):>8.4f} {sig(z)-bound(z, xi):>9.5f}")8.6.2 변분적 매개변수의 최적화
은 하한 를 최대화해 정한다. EM 접근에서 재추정식은
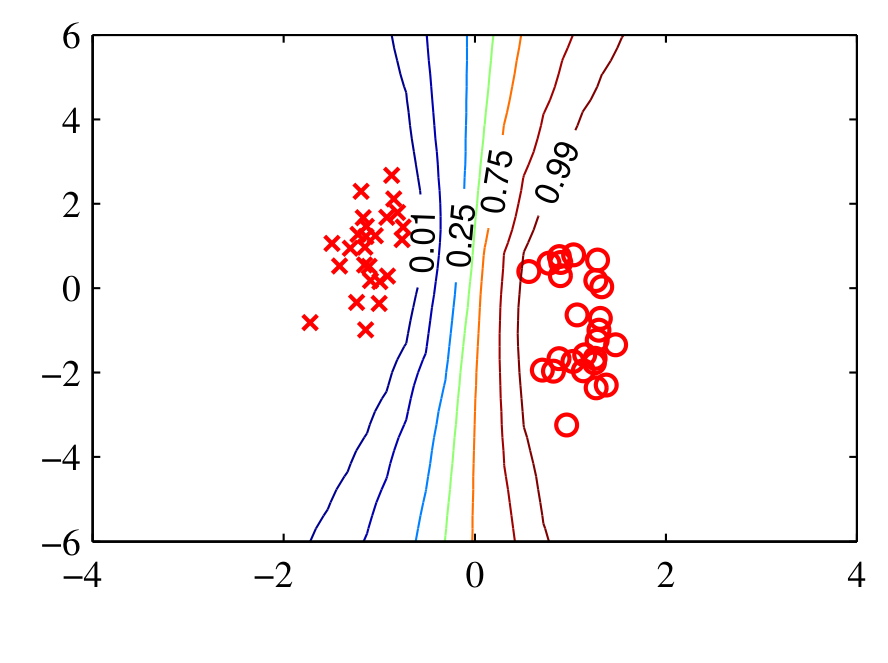
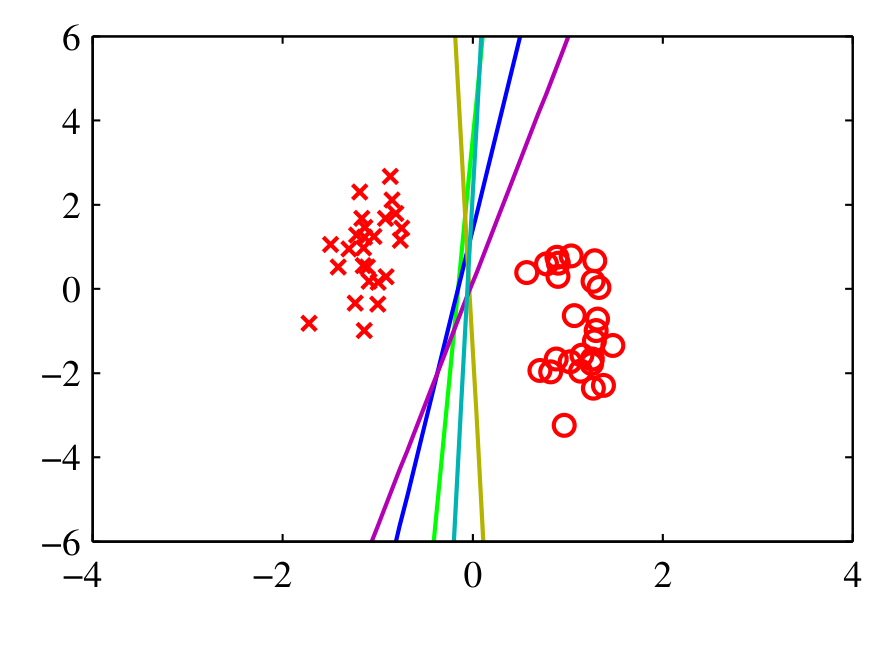
그림 8.7 · 변분적 베이지안 로지스틱 회귀. (왼쪽) 예측 분포와 결정 경계, 데이터에서 멀수록 불확실성 증가. (오른쪽) 사후 분포에서 뽑은
8.6.3 초매개변수 추론
- 초매개변수
까지 데이터로부터 추론하려면 전역 변분법과 지역 변분법을 결합한다. 로 두면 는 가우시안, 는 감마 분포가 되어 번갈아 갱신한다.
8.7 기대 전파 (EP)
- 기대 전파expectation propagation; EP도 결정적 근사이지만, 변분법과 반대로
를 최소화한다. 가 지수족일 때 최소화는 충분 통계량의 기댓값을 맞추는 모멘트 매칭moment matching과 같다( ).
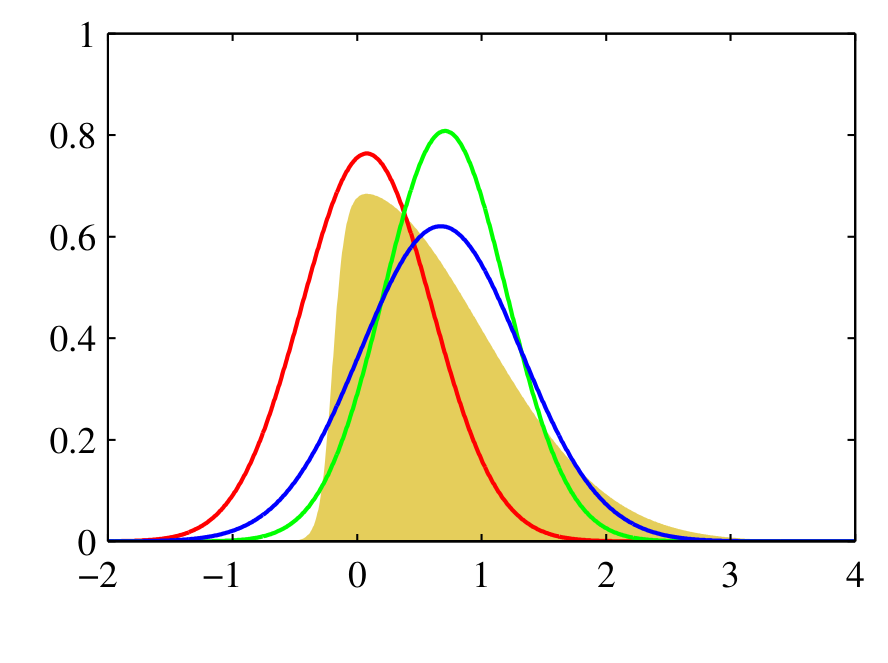
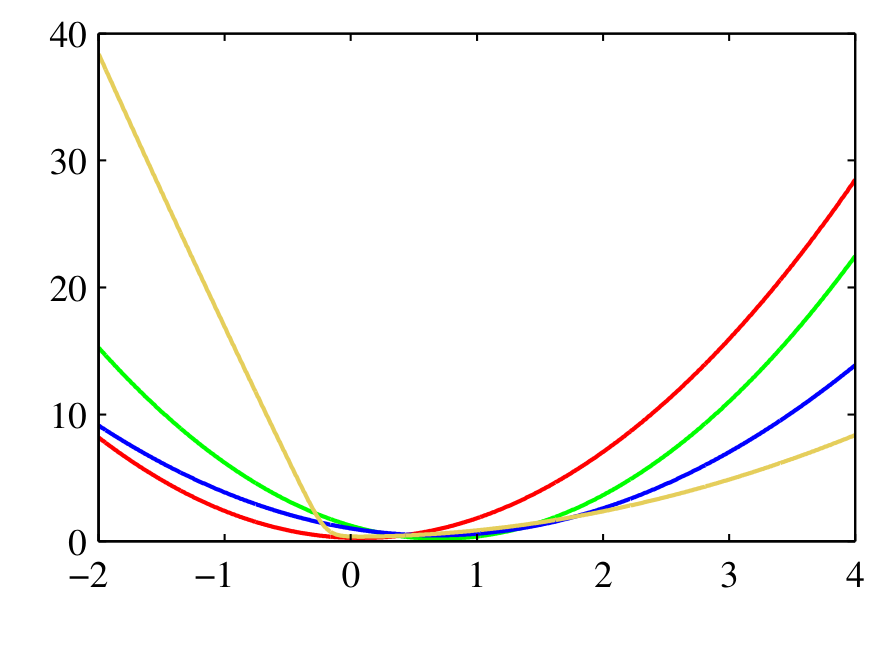
그림 8.8 · 라플라스(적색)·전역 변분(녹색)·EP(청색) 근사 비교. EP는
EP 알고리즘
결합 분포가 인자들의 곱
근사 인자
를 초기화하고 로 둔다. 수렴할 때까지 각 인자
에 대해 반복한다.
제거:
갱신:
의 모멘트를 의 모멘트와 맞추고 를 계산한다. 인자 갱신:
- 모델 증거를
로 근사한다.
연습문제
문제 8.1
관측 데이터의 로그 주변 분포
풀이
임의의 분포
우변에
첫 항은
문제 8.2
로그 로지스틱 함수
풀이
이차 미분은
모든
이 선형 상한의 기울기
문제 8.3
고정 분포
풀이
를 대입하면
즉