3 · 선형 회귀 모델
회귀 모델의 목표는 입력 데이터가 주어졌을 때 그에 해당하는 연속 표적값을 예측하는 것이다. 선형 회귀 모델은 조절 가능한 매개변수를 바탕으로 한 선형 함수를 사용한다.
3.1 선형 기저 함수 모델
- 가장 단순한 선형 회귀linear regression는 입력의 선형 결합
이지만, 입력에 대한 고정 비선형 함수(기저 함수basis function)의 선형 결합으로 확장한다.
여기서
- 대표적 기저 함수로 가우시안
, 시그모이드sigmoid 가 있다( 는 로지스틱 시그모이드logistic sigmoid).
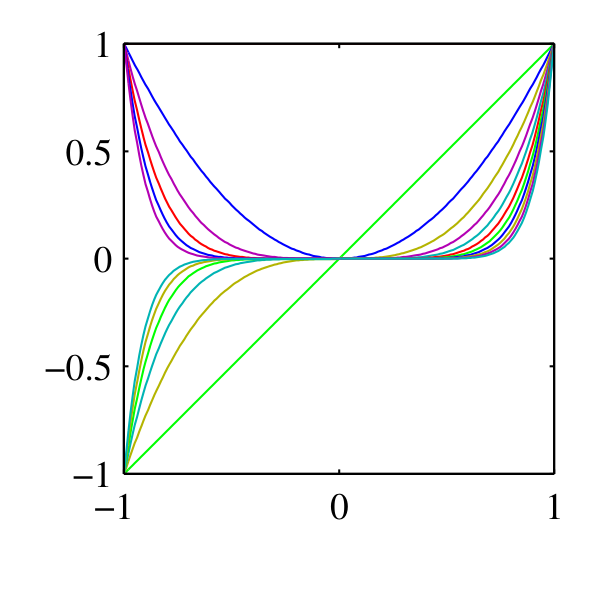
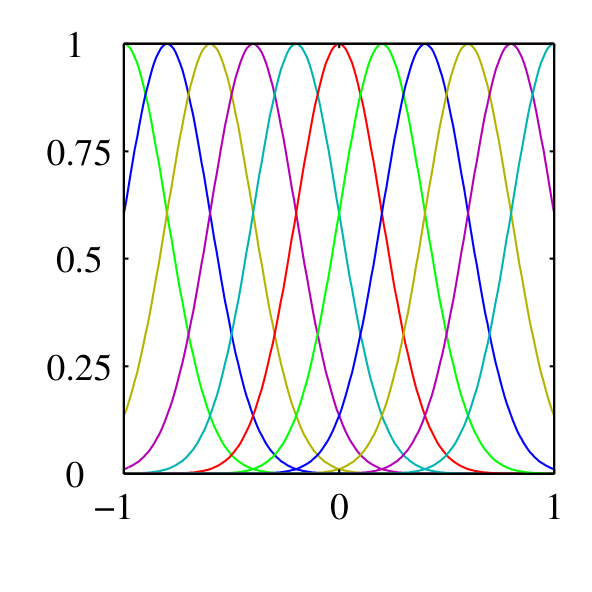
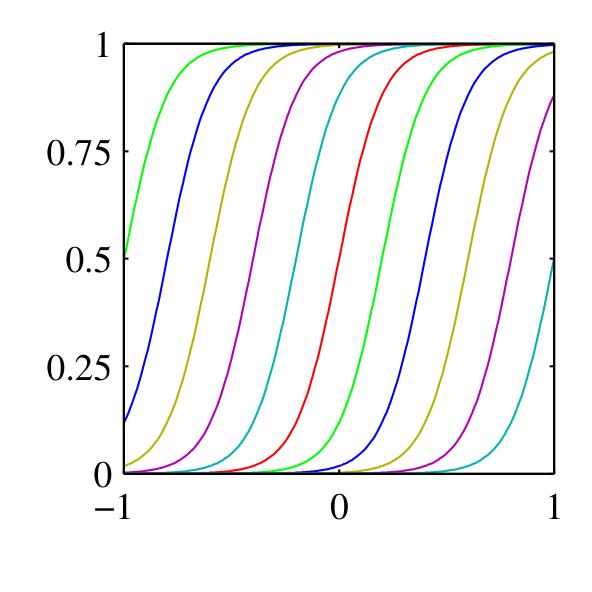
그림 3.1 · 다항 · 가우시안 · 시그모이드 기저 함수.
3.1.1 최대 가능도와 최소 제곱
- 표적값이
, 이라 가정하면 이고, 제곱 오류 하에서 최적 예측은 조건부 평균 이다. - i.i.d. 데이터의 로그 가능도는
이고, 제곱합 오류 함수는
- 기울기를
으로 두고 에 대해 풀면 최소 제곱 문제의 정규 방정식normal equation을 얻는다.
- 편향을 명시하면
( , 는 각 평균)로, 편향이 표적값 평균과 기저 함숫값 평균의 차이를 보정한다. 정밀도는 이다.
실습 · 가우시안 기저 함수 회귀 (정규방정식)
설계 행렬
import numpy as np
rng = np.random.default_rng(0)
N = 25
x = np.linspace(0, 1, N); t = np.sin(2*np.pi*x) + 0.1*rng.standard_normal(N)
mus = np.linspace(0, 1, 9); s = 0.1
def design(x):                                   # [1, 가우시안 기저 9개]
    return np.column_stack([np.ones(len(x)), np.exp(-(x[:,None]-mus[None,:])**2/(2*s**2))])
Phi = design(x)
w = np.linalg.solve(Phi.T@Phi + 1e-8*np.eye(Phi.shape[1]), Phi.T@t)   # 정규방정식
xt = np.linspace(0, 1, 6)
print("가우시안 기저 함수 회귀 (기저 9개 + 편향):")
for xi, yi in zip(xt, design(xt)@w):
print(f" x={xi:.2f}: y_pred={yi:+.3f} sin(2πx)={np.sin(2*np.pi*xi):+.3f}")3.1.2 최소 제곱의 기하학적 의미
차원 공간( 축)에서 는 벡터이고, 기저 함수 ( 의 번째 열)들이 차원 부분 공간 를 이룬다. 예측 는 위에 있으며, 제곱합 오류는 와 의 제곱 유클리드 거리이므로, 최소 제곱 해는 를 에 직교 투영한 것이다.
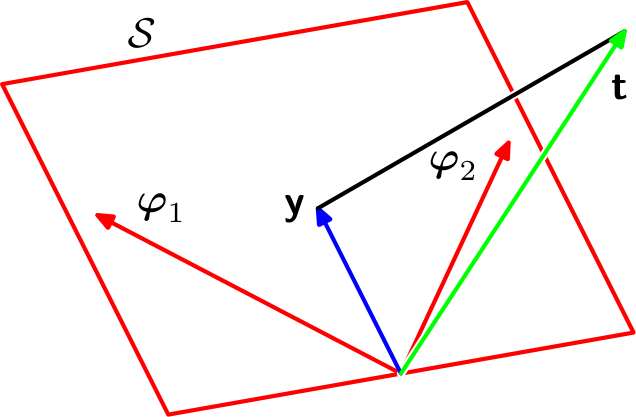
그림 3.2 · 최소 제곱 회귀는 표적값 벡터
3.1.3 순차적 학습
- 전체 데이터를 한 번에 처리하기 어려울 때 순차적sequential 학습을 쓴다. 확률적 경사 하강법stochastic gradient descent은
으로 갱신하며( : 학습률), 제곱합 오류에 적용한 경우를 최소 제곱 평균least mean square; LMS 알고리즘이라 한다.
3.1.4 정규화된 최소 제곱법
- 정규화 오류
에서 가장 단순한 형태(가중치 감쇠weight decay)는 이며, 해는
- 일반화하면
이고, 는 가중치 감쇠, 은 라쏘lasso이다. 라쏘는 가 충분히 크면 일부 계수를 정확히 으로 만들어 희박한sparse 모델을 준다.
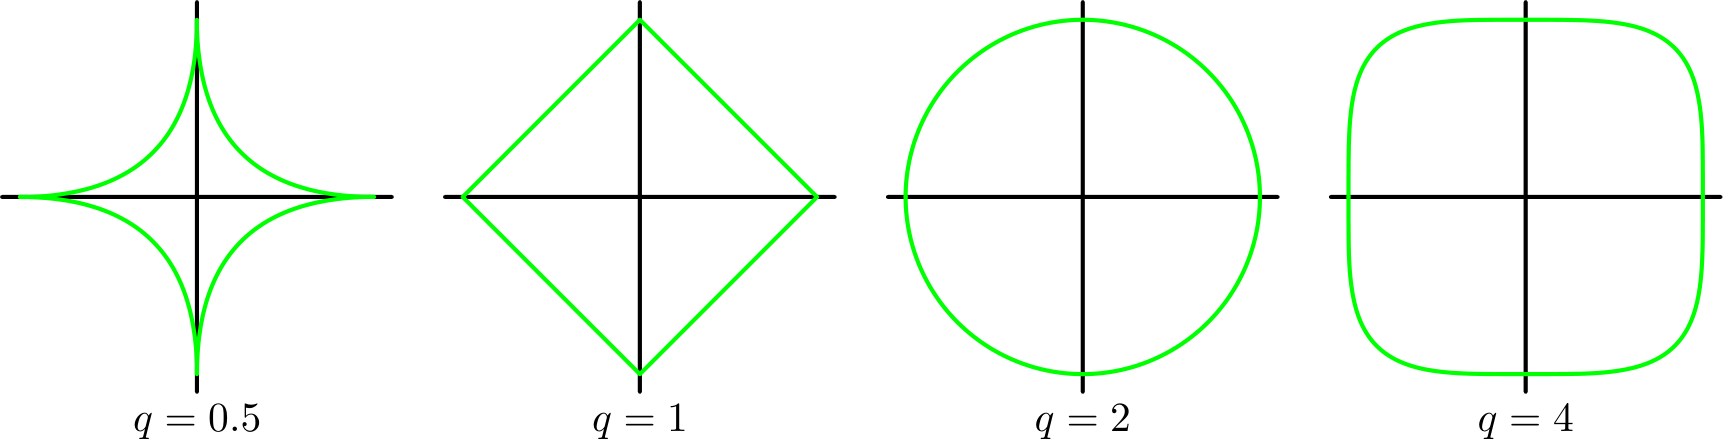
그림 3.3 · 다양한
3.2 편향–분산 분해
- 최적 예측은 조건부 기댓값
이다. 유한한 데이터 집합 로 학습한 예측 의 기대 제곱 오류는 다음처럼 분해된다.
- 편향bias은 전체 데이터 집합에 대한 평균 예측이 회귀 함수와 얼마나 차이 나는지, 분산variance은 각 데이터 집합의 해가 그 평균에서 얼마나 흩어지는지를 나타낸다. 기대 오류는 (편향)² + 분산 + 노이즈로 분해되며, 편향–분산 트레이드오프bias–variance tradeoff가 존재한다(유연한 모델: 낮은 편향·높은 분산, 엄격한 모델: 그 반대).
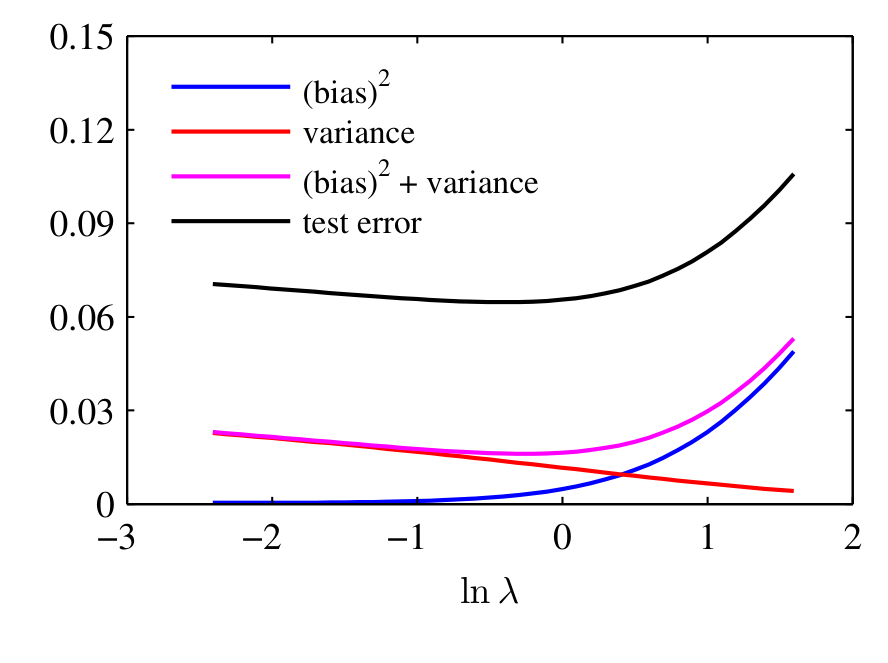
그림 3.6 · (편향)²·분산·합. 둘의 균형점에서 시험 오차가 최소가 된다.
실습 · 편향–분산 트레이드오프
같은 함수를 여러 데이터 집합으로 학습해
import numpy as np
rng = np.random.default_rng(1)
h = lambda x: np.sin(2*np.pi*x)
xtest = np.linspace(0, 1, 50)
mus = np.linspace(0, 1, 9); s = 0.1
def design(x):
    return np.column_stack([np.ones(len(x)), np.exp(-(x[:,None]-mus[None,:])**2/(2*s**2))])
def run(lam, L=300, N=25):
    preds = np.zeros((L, len(xtest)))
    for l in range(L):
        x = rng.uniform(0, 1, N); t = h(x) + 0.15*rng.standard_normal(N)
        Phi = design(x); w = np.linalg.solve(Phi.T@Phi + lam*np.eye(Phi.shape[1]), Phi.T@t)
        preds[l] = design(xtest)@w
    mean = preds.mean(0)
    return np.mean((mean-h(xtest))**2), np.mean(preds.var(0))     # bias^2, variance
print("정규화 λ에 따른 편향²·분산 (가우시안 기저 9개):")
print(f"{'λ':>8} | {'bias^2':>8} | {'variance':>9} | {'합':>8}")
for lam in [1e-3, 0.1, 1.0, 10.0]:
    b, v = run(lam)
    print(f"{lam:>8.3g} | {b:>8.4f} | {v:>9.4f} | {b+v:>8.4f}")
print("λ↑ → 편향 증가, 분산 감소 (편향–분산 트레이드오프).")3.3 베이지안 선형 회귀
- 최대 가능도는 기저 함수 수로 복잡도를 조절해야 해 과적합에 취약하다. 매개변수에 사전 분포를 도입하면 이를 피할 수 있다.
3.3.1 매개변수 분포
- 가능도가
의 이차식 지수 형태이므로 켤레 사전 분포는 가우시안 이다. 제곱식의 완성을 적용하면 사후 분포도 가우시안이다.
사후 분포가 가우시안이므로 최빈값=평균이고 최대 사후 해는
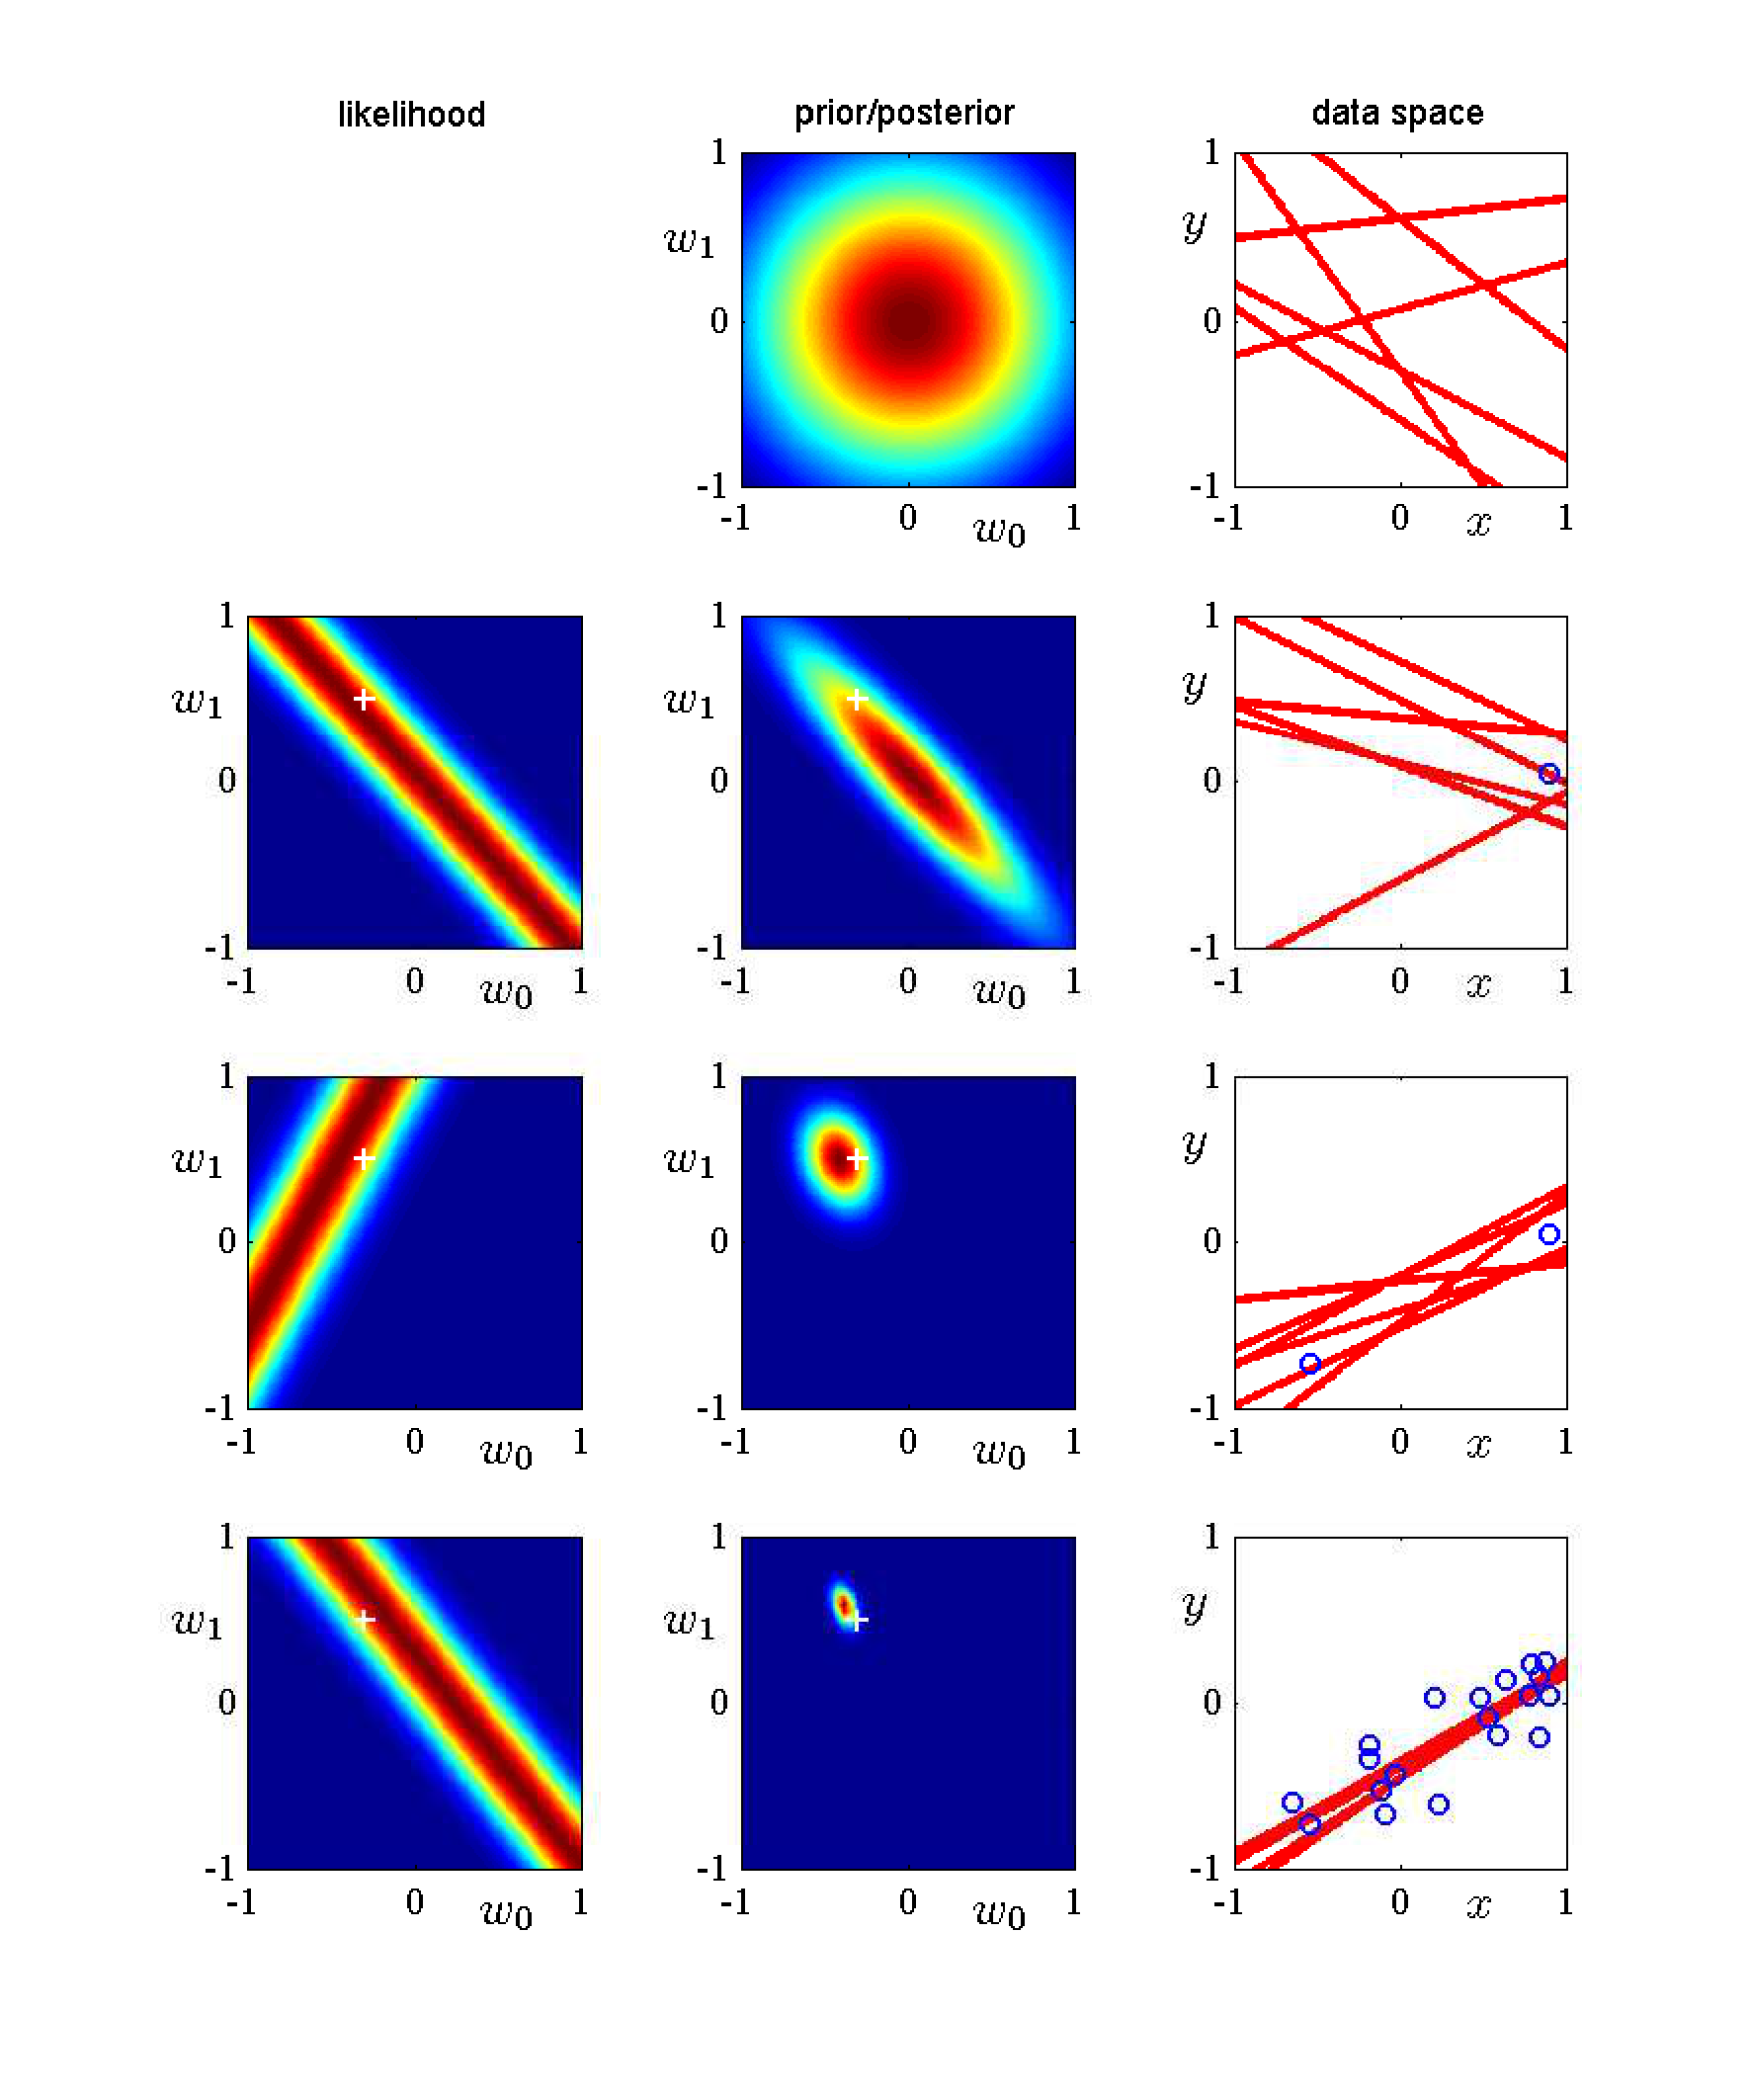
그림 3.7 · 데이터가 늘수록
3.3.2 예측 분포
- 새
에 대한 예측 분포predictive distribution는 에 대해 주변화하여 얻는다.
분산의 첫 항은 노이즈, 둘째 항은
실습 · 예측 분포의 불확실성
데이터 수
import numpy as np
rng = np.random.default_rng(2)
alpha, beta = 2.0, 25.0                          # 사전 정밀도, 노이즈 정밀도
mus = np.linspace(0, 1, 9); s = 0.1
def design(x):
    return np.column_stack([np.ones(len(x)), np.exp(-(x[:,None]-mus[None,:])**2/(2*s**2))])
xt = np.array([0.5])
print("데이터 수 N에 따른 x=0.5의 예측 분포 (베이지안 선형 회귀):")
for N in [1, 5, 25, 100]:
    x = rng.uniform(0, 1, N); t = np.sin(2*np.pi*x) + 0.1*rng.standard_normal(N)
    Phi = design(x)
    SN = np.linalg.inv(alpha*np.eye(Phi.shape[1]) + beta*Phi.T@Phi)   # S_N
    mN = beta * SN @ Phi.T @ t                                        # m_N
    phit = design(xt)
    mean = (phit@mN)[0]
    var = 1/beta + (phit@SN*phit).sum(1)[0]                           # σ_N^2(x)
    print(f"  N={N:3d}: 예측 평균={mean:+.3f}, 예측 표준편차={np.sqrt(var):.3f}")
print("데이터가 늘수록 예측 불확실성(표준편차)이 감소한다.")3.4 베이지안 모델 비교
- 매개변수를 주변화하면 과적합을 피할 수 있고, 모델 선택의 불확실성도 확률로 다룬다.
개의 모델 에 대해 이다. - 모델 증거model evidence
는 주변 가능도marginal likelihood라고도 하며, 두 모델 증거의 비 를 베이즈 요인Bayes factor이라 한다. - 예측 분포
는 모델들의 사후 확률로 가중 평균한 혼합 분포mixture distribution다. 가장 확률 높은 하나만 쓰는 근사가 모델 선택model selection이다. 모델 증거는 사후 분포 계산 시 베이즈 정리의 분모(정규화항)에 해당한다.
연습문제
문제 3.1 · 최소 제곱 해의 직교 투영
행렬
풀이. ①
즉
② 예측
문제 3.2 · 사후 분포 (3.49)의 제곱식 완성
가능도
가우시안 지수부의 표준형
를 얻어 식 (3.49)–(3.51)이 증명된다.